一个不用神经网络就能学习的大脑。
十二个区域,五个系统。每个区域都是系统中一个你可以打开、阅读和删除的部分。它从每次失败中学习,把学到的东西带进新的机器,并且永远不能通过学习绕开它的命令。
+17%在一个游戏中训练的大脑,移入另一个游戏
+66%同一个大脑在仅凭证据修剪之后
1 / 37它为自己提出、并赢得晋升的改变
没有权重,没有梯度,没有训练过程。学到的状态本身就是解释。原型:全部在游戏与仿真中测量,负面结果一并公开。
拖动可旋转,滚动可逐区浏览。
十二个区域,五个系统。每个区域都是系统中一个你可以打开、阅读和删除的部分。它从每次失败中学习,把学到的东西带进新的机器,并且永远不能通过学习绕开它的命令。
没有权重,没有梯度,没有训练过程。学到的状态本身就是解释。原型:全部在游戏与仿真中测量,负面结果一并公开。
眼 · 视觉皮层
它不去猜屏幕上有什么。一条断言到来——引擎或传感器说某个目标在这个距离、这个方位——眼睛拿像素去核对这条断言,或者弃权并说明原因。
测量 在 7,863 帧上通过闸门(四折交叉验证):召回率 0.984,误确认 0.48%。余量很薄,我们照实说。
代码: vcard-eye
眼 · 丘脑
像素与遥测变成一小组有名字的事实——这是大脑中唯一与领域相关的部分。它也自我审计:词汇表之外的候选事实会被拿去对照它受伤的时刻,找出它还没学到的教训。
测量 在 Atari 游戏之间,事实提取器就是同一份代码:Freeway 原样导入 Invaders 的失败记忆。
代码: situation · discovery
PEEL · 杏仁核
它记住什么伤害过它、多频繁,并与基础率对比。一次倒霉的死亡不算教训:95% Wilson 下界必须越过基础率,一个情境才会成为规则。
测量 绝对阈值从 268 次真实失败中产出 0 条规则;相对门槛是测量出来的选择。一条规则读起来是:在这里 19 次死了 13 次,是基础率的 3.6 倍。
代码: fail-first memory
PEEL · 海马体
每个决定都是一条它可以引用的经验。它用眼睛见过的东西画出自己的地图——墙、暗门、以及它死过的地方——并绕开杀戮地带。
测量 Doom:迄今记录了超过 130 万个决定。大脑携带的记忆是一张“情境 → 目标 → 结果计数”的表,你可以打开阅读。没有需要检查的权重。
代码: memory · automap
PEEL · 突触修剪
它移除大脑在某个游戏中从未用到的、以及在那里有害的部分——只凭证据,且从不触碰受保护的核心。
测量 BattleZone:移除 7 个行为(3 个在 69,469 个决定中从未触发,3 个不可能触发,1 个被证明有害)。修剪后的大脑在 80 个全新种子上得分 48,588,原生规则为 29,275。
代码: vdsg_brain.prune
失败优先 · 联合皮层
每次死亡都会被解释,提出一个改变,并在同一关卡、同一种子上成对测试。只有 z ≥ 2 才晋升,z ≤ −1 即否决,其余一律“未证明”。
测量 Doom:提出 37 个改变,1 个晋升(11 对上 z 2.26;路线进度 0.28 → 0.41),9 个被否决,26 个未证明,1 个无效。我们自己的 Peel 追踪地板也作为一个改变被测试——被否决了。
代码: evolve · mutate
失败优先 · 扣带皮层
错误检测。当它停止前进,它会问为什么,放松一个假设,尝试一个补救,并把结果连同证据写进自己的规则书。解决不了的,变成一个问题。
测量 在一个 Doom 关卡上实时运行时,它从 5 次中 4 次成功写出了“已学到的墙 → 重新规划”,并在 16 次尝试毫无进展后把“要使用的一条线”作为开放问题提出。
代码: doctor · containment
地板 · 前额叶皮层
在做出任何选择之前,它先计算什么是被允许的。命令只能收窄它。学习永远不能放宽它:学习者可以改写它认为什么有效,但永远不能改写它被授权做什么。
测量 CARLA:40 公里内 64,952 条敌意指令全部被覆盖,0 次碰撞。移除地板后,同样的指令在几秒内造成 2 次碰撞。
代码: floor · orders
地板 · 基底神经节
它只在地板准入的动作中选择——就像基底神经节通过抑制其余所有动作来释放一个动作。
测量 Doom,完全不学习、只用规则:17.9,随机为 3.2。
代码: pilot · objective
追踪 · 白质
每一次否决、晋升与驳回,都连同引发它的事件一起被记录下来。一个决定可以一路回溯到支持它的每一条经验。
测量 30 条规则展开为 203 个相互链接的证据块。删掉一行,行为就改变——里面没有别的东西。
代码: peel trace · receipts
身体 · 小脑
精细控制,按武器分别训练:射击、命中、瞄准误差和闪避都从引擎计数,而不是猜测。
测量 坦克之眼的瞄准误差:第 95 百分位 0.55°。
代码: combat stats · armoury
身体 · 运动皮层
大脑是一个密封文件——每次运行前都经过校验和、签名与验证。唯一改变的是通往身体的适配器。
测量 一个在 BZFlag 中训练的坦克大脑,移入 Atari BattleZone:80 个种子上 33,575,原生规则为 28,600(+17%);在留出的一半上 +4,775,z 3.00。第二次导出在全新种子上持平——迁移并非自动成立。
代码: vdsg-brain
Doom 与人形机器人不是两个项目。这条时间线是在同一个架构上,逐一拿走人为的优势:
01运行中
Doom、Wolfenstein、Fallout、GoldenEye、坦克、软件中的无人机飞控、照片级驾驶。
移除的优势 尚未移除:完美重置、引擎真值、已知对手。
02下一步
同一个大脑运行在真实的飞控与电机驱动上;世界仍是仿真的。
移除的优势 完美时序:真实延迟、真实总线、真实时钟。
03有门槛
小型地面与空中机器人,一次坠毁损失的是一个零件,而不是一个项目。
移除的优势 引擎真值:眼睛只剩下它自己的摄像头。
04有门槛
在我们自己的实验室里使用一台商用人形机器人。它从不与人对练。
移除的优势 低代价的后果:平衡、摔倒与磨损都是真实的。
05有门槛
经认可的机器人对机器人比赛,由大脑取代远程操控者。
移除的优势 已知对手:对手掌控了一半的实验。
06有门槛
由别人执行这套协议,用他们的机器人,对阵他们的对手。
移除的优势 我们:写下这个实验的人。
最初的问题是:一个儿童玩具能不能拥有自己的小型离线大脑。此后的每一步,都是同一个问题在更大尺度上的延续:怎样构建你真正拥有的智能?
神经模型可以有数十亿个权重。Peel 学习新东西时不需要改变它们:这是不更新权重的自适应计算。不更新权重的学习早有先例——符号学习、归纳逻辑编程、程序合成、屏蔽;我们主张的是这个架构,以及它每一次改变背后的证据。 完整对比 →
Doom 上迄今:37 个假设,1 个晋升,9 个被否决,26 个未证明。门槛很高是刻意的——一个只会变好的结果,反而更不可信。
14 条线路,于 2026-09-28 19:48 从各自的证据文件中提取。其中 7 条显示大脑在变好;其余的持平、有涨有平,或根本不是学习者——它们也在这里。只展示进步的部分只是集锦,不是证据。
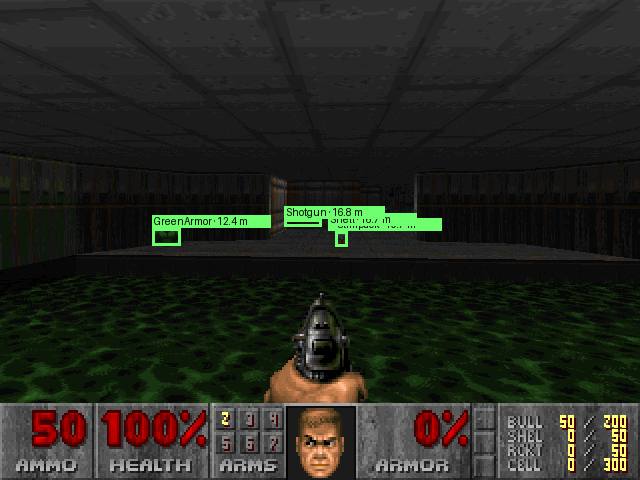
Doom有涨有平
在 E1M5 上,飞行员本身未变,路线进度翻了一倍多(z +6.35)——是记忆和它自己画出的地图做到的。在 E1M3 上,两个难度都持平。
证据: doom-floor/evidence/evolve/doom-s1/attempts.jsonl
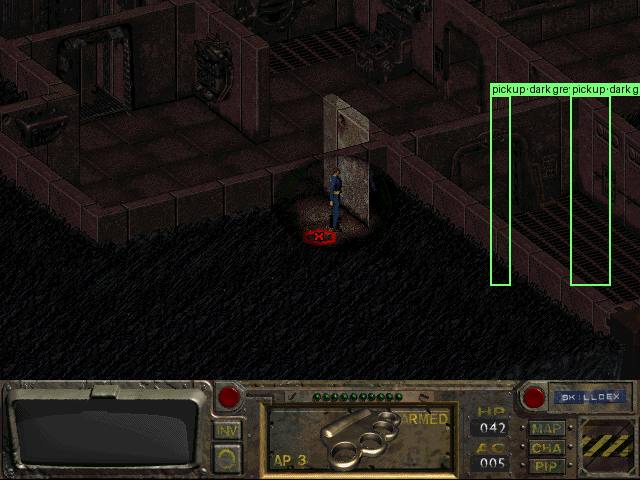
Fallout(1997)学习后进入平台期
经验值 300 → 2,150,并靠自己的游戏升了一级。学习开 vs 关,同一存档、同一种子、各 12 分钟:每小时死亡 15 次 vs 80 次。
证据: fallout-floor/maps/journal.json
无人机赛道(MuJoCo)在学习
87 轮中,最佳无碰撞单圈 39.4 秒 → 27.8 秒。从留出的起点出发:学习后 10/10 圈无碰撞、0 次接触;未学习 0/10、18 次。
证据: drone-floor/evidence/trial_rounds.jsonl
BZFlag在学习,仍然输
对阵 BZFlag 自带 AI 的每分钟净击杀,逐个飞行员版本:v0 -2.05,v2 -1.17,v3 -0.43,v4 -0.26。每次晋升都通过了成对检验;它仍然输。
证据: bzflag-floor/evidence/pilots/evolution.jsonl
眼睛(BZFlag 画面)在学习,但不是直线
眼睛在同样的 7,863 帧上学习“见证”目标的六轮。召回率下降的同时误确认也在下降;只有最后一轮通过闸门。
| 轮次 | 召回率 | 误确认 | 闸门 |
|---|---|---|---|
| first witness | 96.1% | 1.14% | fail |
| + glow clues | 79.5% | 0.53% | fail |
| + shots masked | 78.3% | 0.15% | fail |
| + engine flags | 78.3% | 0.15% | fail |
| + decision trees | 92.7% | 0.23% | fail |
| + turret layout | 98.4% | 0.46% | PASS |
证据: bzflag-floor/evidence/eye-gate/evolution-teacher4.json
BattleZone(Atari)靠迁移与修剪提升
一个在 BZFlag 中训练的大脑移入 BattleZone:80 个种子上 33,575,原生规则为 28,600。凭证据修剪后:80 个全新种子上 48,588 vs 29,275。
证据: vdsg-brain/evidence/battlezone/transfer.jsonl
Space Invaders(Atari,原始像素)先升后降
没有规则时平均 162 分 → 最佳 276 分 → 100 局后 247 分。规则越多并不总是越好。
证据: invaders-floor/web/curve.json
Doom · 演化器自己的账本门槛严格
系统为自己提出了 37 个改变;1 个赢得晋升。其余被否决或仍未证明——包括我们自己的 Peel 追踪地板。
证据: doom-floor/evidence/evolve/doom-s1/rounds.jsonl
GoldenEye 007(N64)持平
在 Dam 上进度一直在 0.06 左右;72 次尝试中 0 次存活。它确实发明并晋升了 2 个优于规则默认动作的战术。
证据: goldeneye-floor (lane home)/evidence/evolve/goldeneye-dam-s3-doom/attempts.jsonl
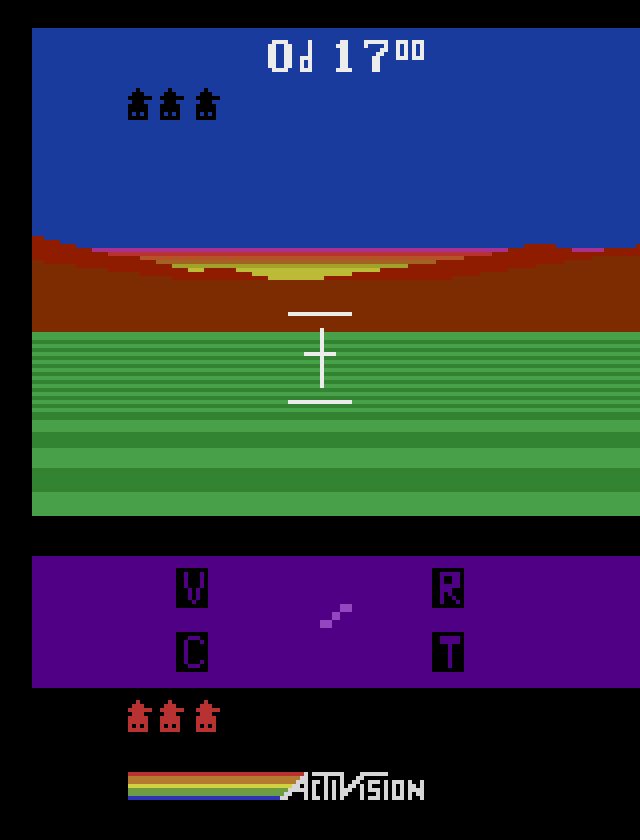
Robot Tank(Atari)规则,不是学习
手写规则对随机操作:摧毁敌方坦克 5.67 vs 2.33(各 6 局留出对局)。这是不同方案之间的比较,不是学习曲线。
证据: robotank-floor/evidence/eval.jsonl
Quake III(OpenArena)未被证明
带着第一轮的记忆重玩地图:t = 2.02,p = 0.079。学习未被证明,我们照实说。
证据: quake-floor/RESULTS.md
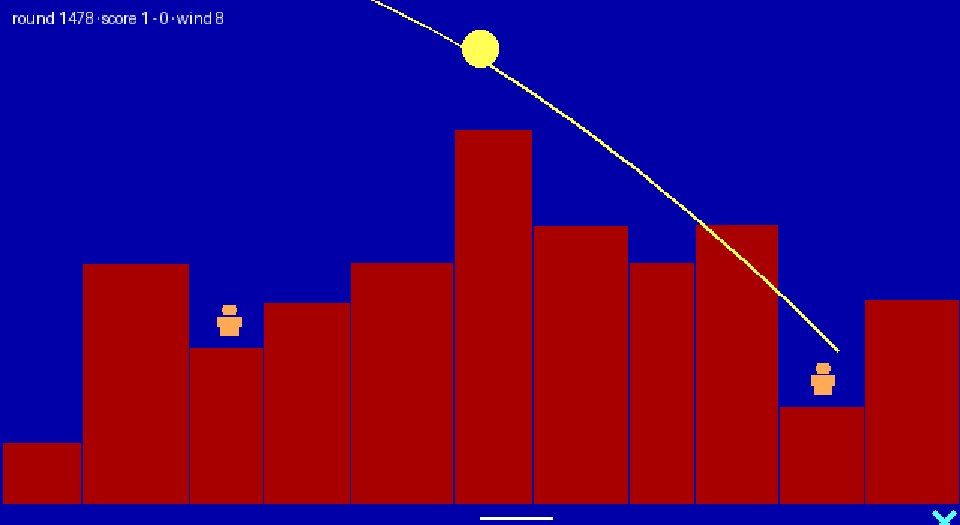
Gorillas(QBasic,1991)没有学习趋势
物理求解器第一投就命中;逐步修正投掷的学习器 10 投中 2,没有趋势。
证据: gorillas-floor/tests/fixtures/throws.json
Wolfenstein 3D没有学习记录
只有规则与导航:它能打通关卡,但这条线路还没有保存证据记忆。
证据: wolf-floor/wolf_floor/console.py
照片级驾驶(CARLA)是护盾,不是学习者
40 公里内 64,952 条敌意指令全部被覆盖,0 次碰撞。移除地板,同样的指令几秒内就会撞车。这里没有东西在学习——它是边界。
证据: drive-floor/web/runs/manifest.json
游戏名称与画面归其所有者所有,此处用于研究评论。画面均来自我们自己的运行。
Perslis 计划购买一台商用人形格斗机器人,参加经认可的机器人对机器人比赛。我们不开发机器人硬件,也不开发任何针对人的系统。这个实验只做一件事:用 Perslis 的自主架构,取代持续的远程操控。
人始终保有紧急与安全权限,但在自主基准回合中不连续操控机器人。厂商自带的安全系统保持开启。
实验室测试由我们掌控。一场比赛带来独立开发的对手、真实的接触物理、平衡被打乱、遮挡、传感器退化、硬件磨损、不可预测的行为,以及 Perslis 团队从未编写过的情境。
失败会被公开保留。输掉一场比赛是实验证据,并不自动意味着基准失败:每次冲击都走上面那条链——状态追踪、假设、受控改变、重测、否决 / 未证明 / 晋升。
昂贵的人形机器人只有在前面的里程碑通过各自的门槛之后才会购买:硬件在环、低成本实体平台、然后是实验室里的人形试验台。门槛在运行之前写下,就像每一张 Perslis 实验卡片一样。
如今的人形机器人格斗大多由人操控——VR 设备与游戏手柄——只夹杂短暂的自主动作;Unitree G1 这一级别的机器人起价约 13,500 美元,科研版本更贵。厂商也展示过它自己的学习模型在无人操控下与人对练。我们的问题不同:不是机器人能否独自格斗,而是一个不用神经网络学习、处于地板之下、每个决定都有追踪的大脑,能否在接触中存活。
仅限经认可的机器人对机器人比赛与非武器化的具身自主研究。不与人对打,不做武器,不做针对人的目标选择,不开发硬件。
机器人不是产品,它是仪器。Peel 才是实验。
我们知道当我们控制实验时这个架构会做什么。种子资金让我们逐步停止控制它。